Raison 1
Vos échanges B2B débordent de données personnelles
Envoyer un email brut à un modèle tiers, c’est lui transmettre des noms, des signatures et parfois les données de vos propres clients.
Décryptage · RGPD · IA agentique · B2B
Vos agents IA lisent vos emails, vos tickets et vos contrats. Avant qu’ils les envoient à un modèle tiers, une étape simple protège les personnes citées et votre conformité.
L’essentiel en 30 secondes
Si vous ne lisez que ce bloc, retenez ceci. Le détail de chaque point suit plus bas.
Raison 1
Envoyer un email brut à un modèle tiers, c’est lui transmettre des noms, des signatures et parfois les données de vos propres clients.
Raison 2
L’article 32 nomme la pseudonymisation parmi les mesures de sécurité appropriées. Elle masque l’identité de manière réversible, sous votre contrôle.
Raison 3
Le modèle comprend le contexte et résout la demande sans jamais savoir qui l’a écrite. Vous ré-identifiez la réponse chez vous.
Raison 1 · Le risque
Plus un agent est autonome, moins on voit où partent les données qu’on lui confie.
Les modèles frontaliers et les IA agentiques transforment les opérations B2B. Analyser une correspondance commerciale, trier des tickets, préparer une relance : le gain de productivité est réel. Mais ces outils changent l’échelle du traitement, et donc l’échelle du risque pour les données personnelles.
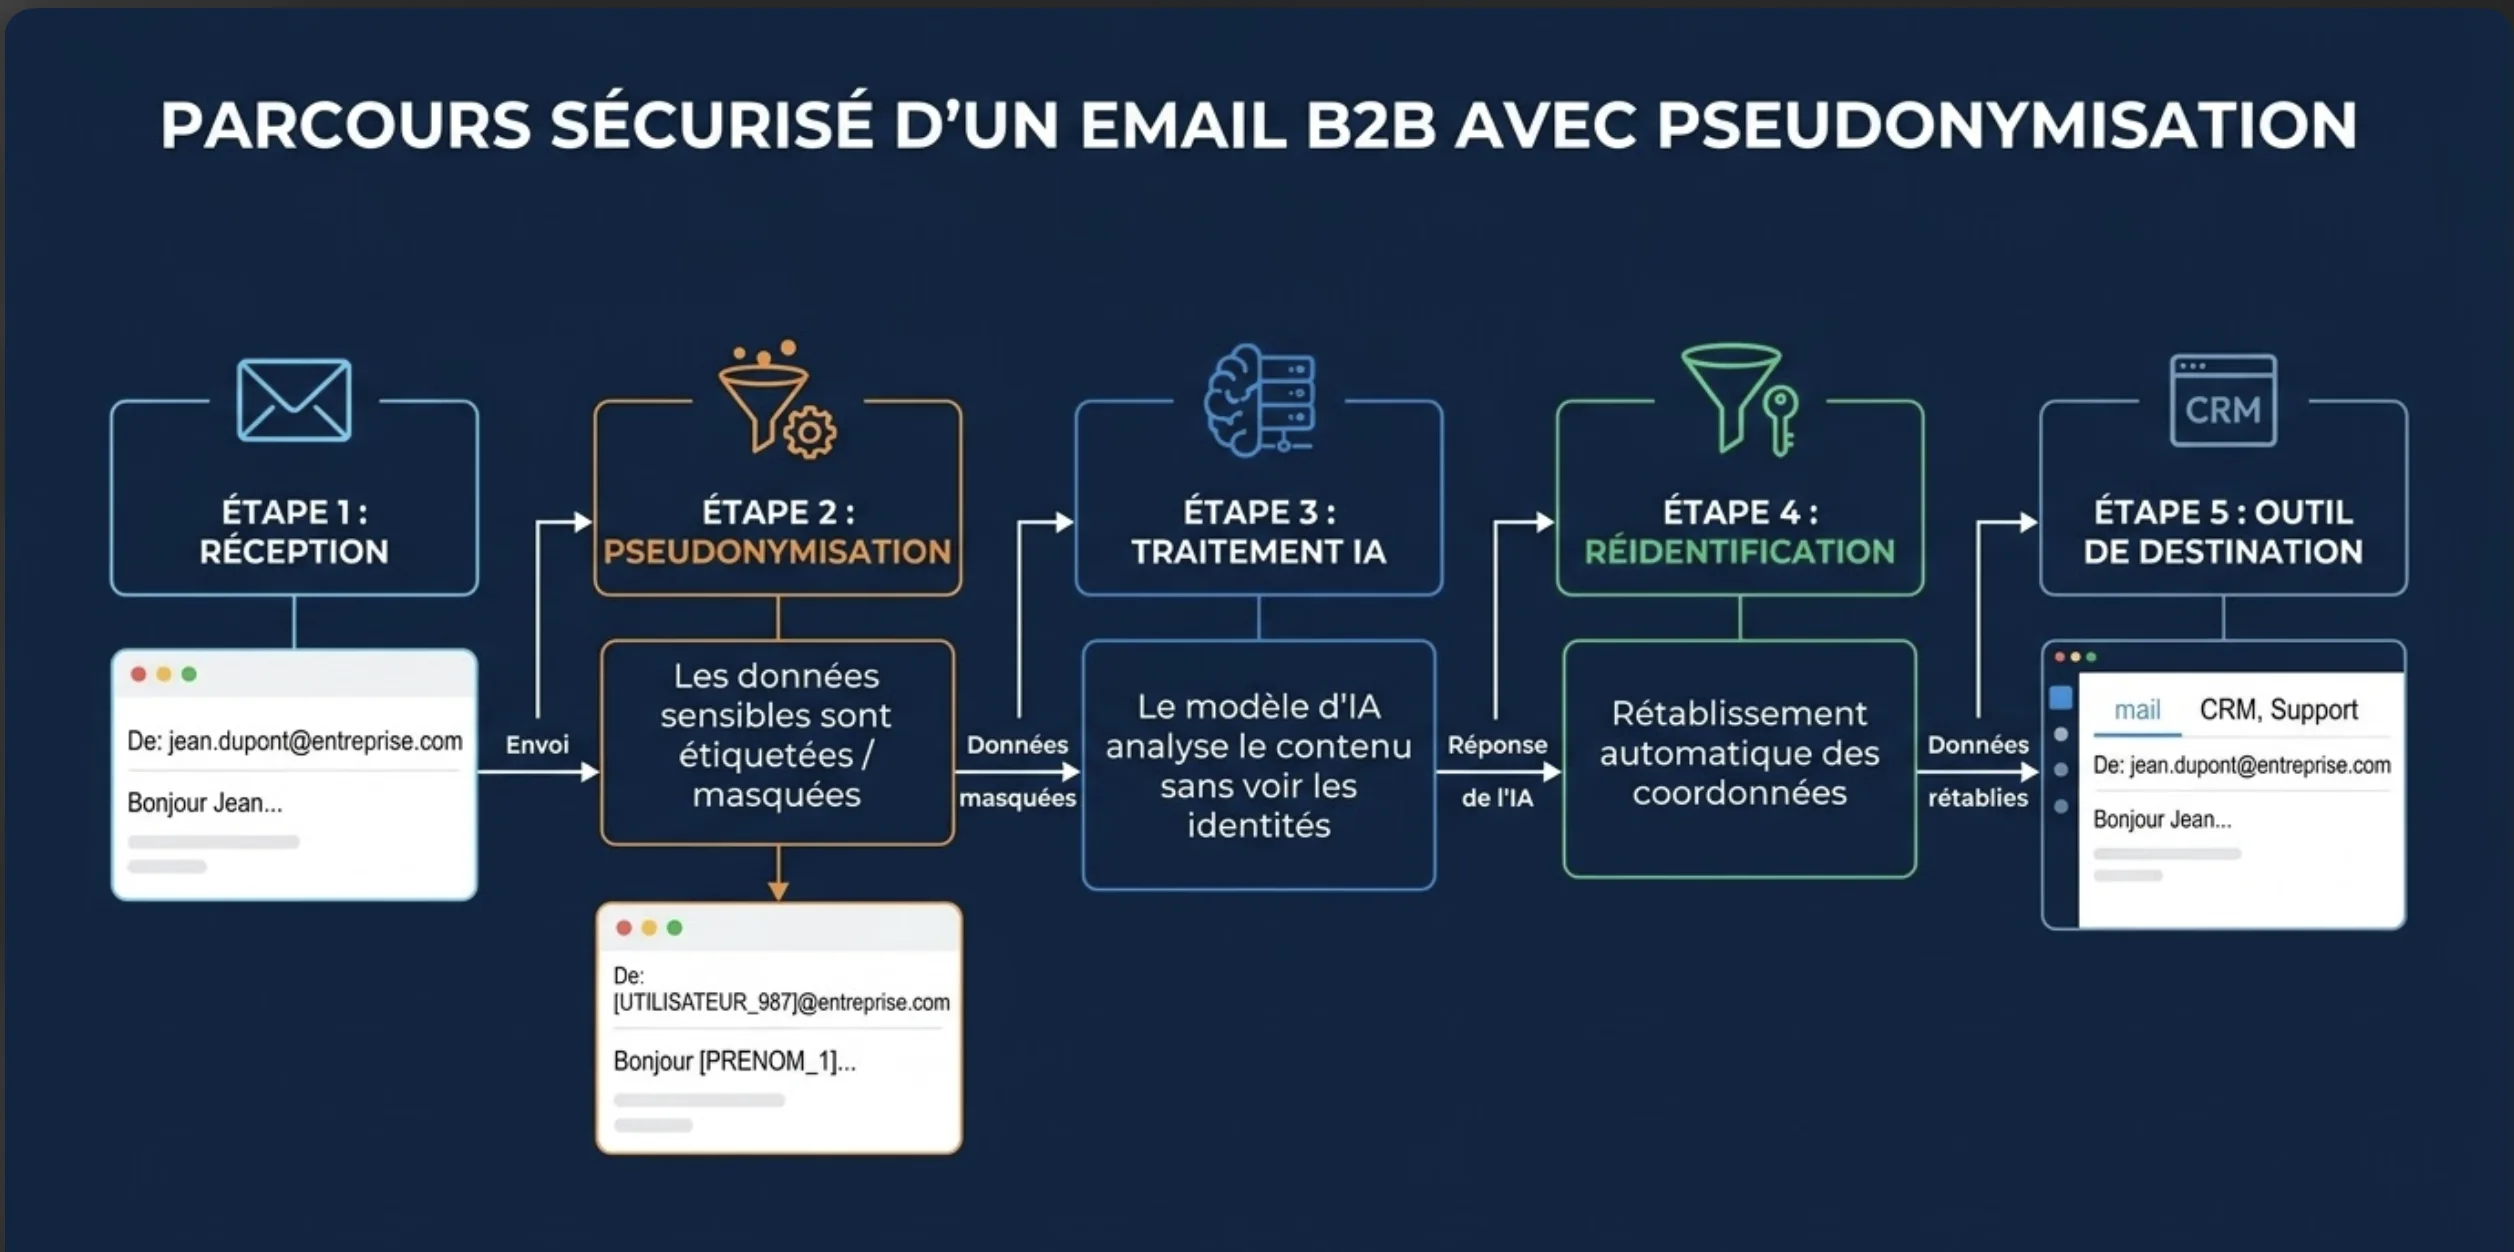
Dans un contexte B2B, les emails échangés avec vos clients, partenaires et fournisseurs contiennent en permanence des données à caractère personnel. Elles passent inaperçues parce qu’elles font partie du décor de chaque message.
prenom.nom@client.be identifie une personne aussi sûrement que son nom complet.
Nom, fonction, portable direct, parfois une photo : tout part avec le message.
Un ticket de support cite souvent le client de votre client : son compte, sa commande, son adresse.
Transmettre ces correspondances en clair à un modèle frontalier vous expose à un risque de non-conformité sérieux.
Les IA agentiques enchaînent les tâches et connectent les services entre eux. Les flux deviennent opaques, et les personnes concernées perdent la maîtrise de leurs données.
Une donnée brute envoyée à un modèle tiers peut rester dans la mémoire d’un agent, ou être réutilisée là où personne ne l’a autorisé.
Raison 2 · Le cadre légal
Pour concilier innovation et conformité, la pseudonymisation est l’outil le plus direct.
Le texte
Art. 32(1)(a)
Le RGPD cite « la pseudonymisation et le chiffrement des données à caractère personnel » parmi les mesures techniques appropriées pour sécuriser un traitement.
L’article 32 demande des mesures de sécurité adaptées au risque. Il ne fixe pas de liste fermée, mais il nomme explicitement la pseudonymisation.
Les lignes directrices 01/2025 du Comité européen de la protection des données (EDPB) ajoutent qu’elle sert aussi la protection des données dès la conception, prévue à l’article 25.
Le principe du coffre-fort. Les données identifiantes sont remplacées par des étiquettes neutres. Pour retrouver la personne, il faut une table de correspondance ou une clé, conservée séparément et sous votre seul contrôle.
Seule la pseudonymisation protège l’identité tout en laissant l’IA comprendre qui fait quoi.
A
B
C
Selon l’EDPB, une donnée pseudonymisée reste une donnée personnelle tant qu’on peut la relier à quelqu’un. Elle réduit fortement le risque, mais ne vous dispense ni d’une base légale, ni d’un contrat de sous-traitance, ni des autres mesures de sécurité.
Raison 3 · Le bénéfice
Des étiquettes cohérentes préservent le sens du message. L’agent raisonne aussi bien, sur des identités qu’il ne connaît pas.
De : sophie.martin@brasserie-exemple.be Objet : Retard commande n° 48213 Bonjour, Notre livraison du 12 mars au 14 rue des Tanneurs, Mons n’est pas arrivée. Pouvez-vous voir avec Marc Lenoir de votre équipe ? Sophie Martin · Responsable achats +32 475 00 00 00
De : [EMAIL_1] Objet : Retard commande n° [REF_1] Bonjour, Notre livraison du [DATE_1] au [ADRESSE_1] n’est pas arrivée. Pouvez-vous voir avec [PERSONNE_2] de votre équipe ? [PERSONNE_1] · Responsable achats [TÉLÉPHONE_1]
Côté modèle
Un client signale un retard, il faut prévenir un collègue précis et proposer une nouvelle date. Le modèle rédige sa réponse avec les étiquettes, sans jamais connaître l’émetteur ni les tiers cités.
Côté entreprise
Au retour, la ré-identification se fait dans votre environnement. Avec AgentSpot, c’est une fonctionnalité standard : noms, dates, adresses et coordonnées sont remplacés automatiquement avant tout traitement.
Passer à l’action · Privacy by design
C’est la règle d’or. Voici comment l’appliquer en quatre étapes, avant d’étendre vos agents à d’autres équipes.
Lister les agents en production, les sources qu’ils lisent (boîte mail, CRM, support) et les modèles qu’ils appellent.
Placer une couche de pseudonymisation entre vos données et chaque appel au modèle, sans exception manuelle.
Stocker la table de correspondance séparément, avec un accès restreint et journalisé. Ré-identifier uniquement au retour.
Inscrire la mesure au registre des traitements, mettre à jour l’analyse d’impact si elle est requise et les contrats de sous-traitance.
À retenir
La pseudonymisation n’est pas une case à cocher. C’est le rempart qui vous permet d’utiliser toute la puissance de l’IA en gardant le contrôle, et la preuve de ce contrôle, sur les données de vos clients.
Vos agents. Votre cap.
En 30 minutes, nous faisons passer un échange réel de votre équipe dans AgentSpot et vous montrons ce que le modèle voit, et ce qu’il ne voit plus.